
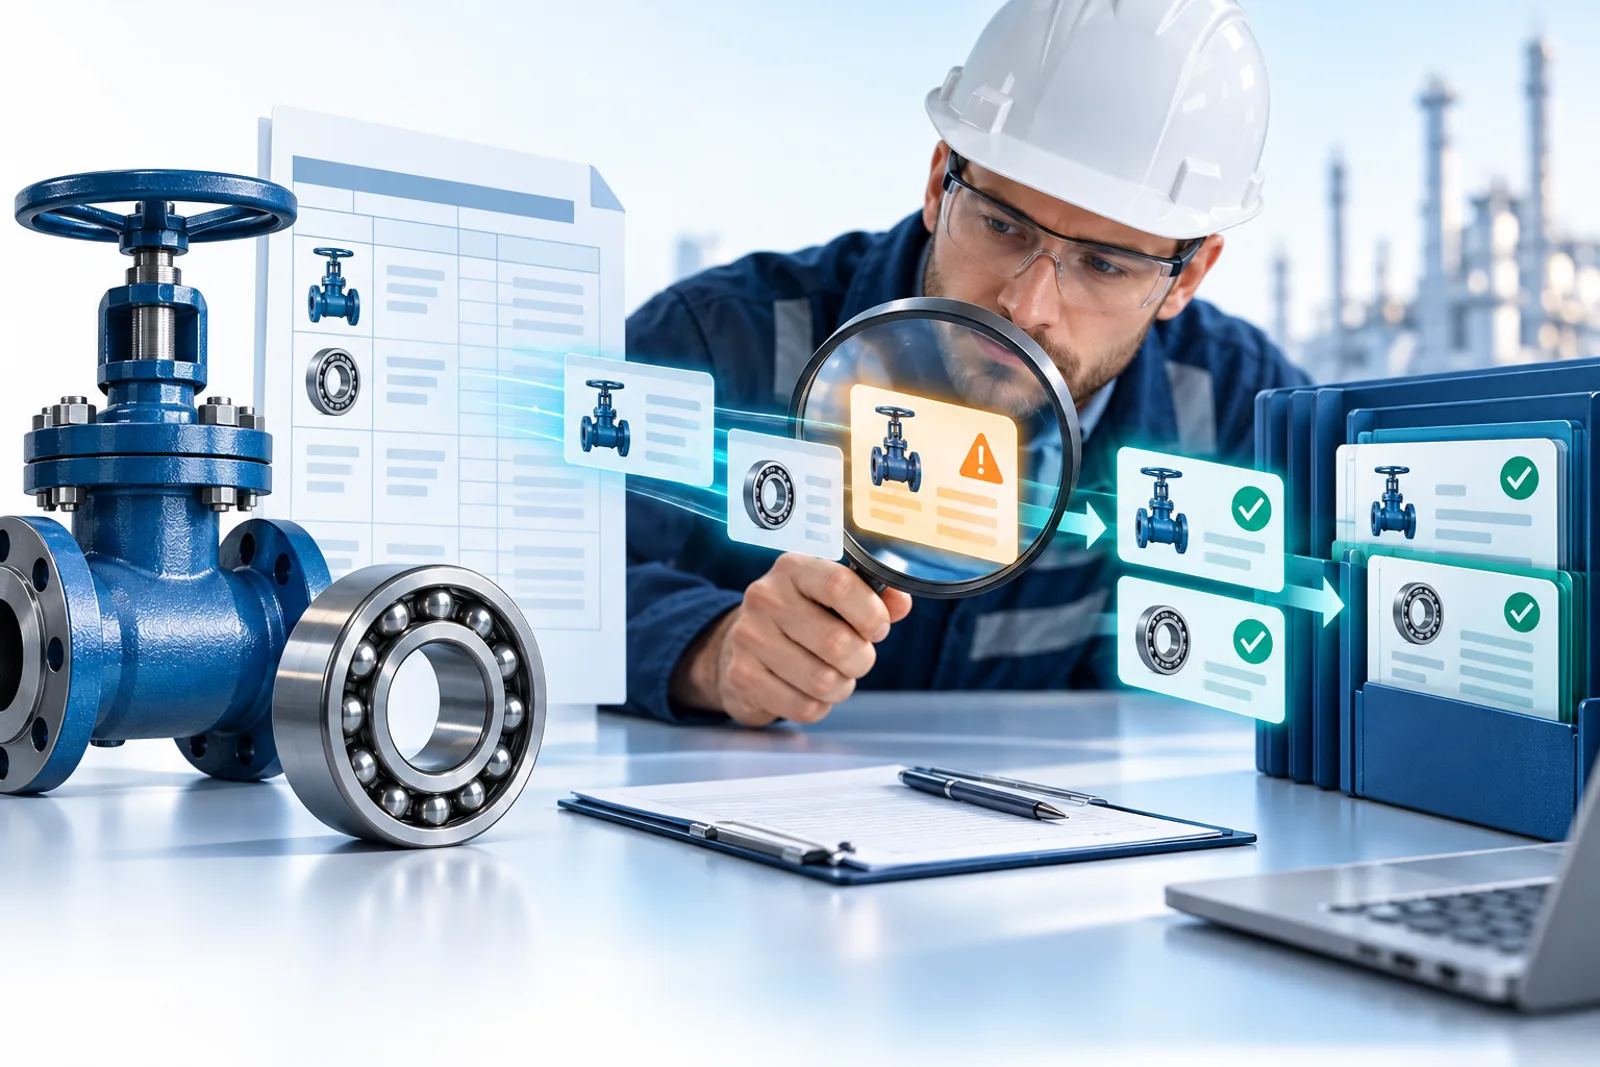
یک فایل کالا وارد شده، همه ردیفها پردازش شدهاند و سامانه پیام موفقیت میدهد. آیا اکنون نام، کلاس و ویژگیهای هر کالا قابل استفادهاند؟ پاسخ به معنای «موفقیت» بستگی دارد. موفقیت فنی میتواند نشان دهد عملیات بدون خطا اجرا شده است؛ صحت تخصصی اطلاعات، پرسشی جداست.
در ورود اطلاعات با هوش مصنوعی، سازمان به مرحلهای نیاز دارد که برداشت مدل را با متن منبع و مدرک کالا مقایسه کند. این مرحله نباید فقط یک دکمه تأیید کلی باشد؛ باید تصمیمهای مشخص و قابل پیگیری ایجاد کند.
سه سطح کنترل را جدا کنیم
نخست، کنترل خواندن فایل است: آیا ستون درست خوانده شده و هر ردیف شناسه قابل پیگیری دارد؟ دوم، کنترل ساختار خروجی است: آیا نتیجه به ردیف ورودی مربوط است و فیلدهای مورد انتظار را دارد؟ سوم، بررسی معناست: آیا کلاس، نام و ویژگی پیشنهادی واقعاً از ورودی یا مدرک معتبر پشتیبانی میشوند؟
عبور از دو سطح اول، سطح سوم را تضمین نمیکند. یک مقدار میتواند از نظر قالب کاملاً معتبر و از نظر فنی نادرست باشد. مقاله ورود فهرست قدیمی کالا حفظ رابطه هر ردیف منبع با مقصد را بررسی میکند؛ موضوع این مقاله، پذیرش محتوای استخراجشده در همان رابطه است.
مثال صنعتی: یک عدد، چند برداشت
فرض کنید در ردیفی نوشته شده «شیر مدل ۲۵، فلنجی» و ستون توضیحات خالی است. در این مثال فرضی، AI عدد را اندازه اتصال تلقی میکند، در حالی که ممکن است بخشی از نام مدل باشد. خروجی مرتب است و فیلد اندازه نیز مقدار دارد، اما متن منبع این برداشت را قطعی نکرده است.
بازبین باید بتواند مقدار را رد کند یا «نیازمند مدرک» بگذارد. اگر سند مربوط به مدل دقیق بعداً اندازه اتصال را روشن کرد، ویژگی با همان شاهد پذیرفته میشود. حذف ابهام از ظاهر صفحه، با حل ابهام فنی برابر نیست.
بازبینی باید در سطح ویژگی ممکن باشد
ممکن است عنوان پیشنهادی مناسب باشد، کلاس نیاز به اصلاح داشته باشد و جنس بدنه هنوز معلوم نباشد. تأیید یکجای ردیف این تفاوتها را پنهان میکند. نرمافزار باید بتواند پذیرش، اصلاح یا تعلیق را برای بخشهای مؤثر اطلاعات ثبت کند.
نمایش متن اصلی کنار نتیجه کمک میکند کارشناس بفهمد چه چیزی استخراج شده و چه چیزی افزوده شده است. اگر مقدار به مدرک بیرونی وابسته است، آن مدرک باید قابل مشاهده باشد. منبع اطلاعات کالا و پیگیری داده توضیح میدهد چرا مقدار بدون منشأ برای تصمیم قابل دفاع کافی نیست.
مسئولیت انسان را روشن کنیم
چارچوب NIST درباره تعامل انسان و AI بر روشن بودن نقشها و مسئولیتهای انسانی تأکید دارد و کاربردها را از تصمیمگیری خودکار تا تصمیمگیری انسانی تفکیک میکند. این چارچوب حکم یکسانی برای تمام کاربردهای AI صادر نمیکند. در شناسایی صنعتی نیز سازمان باید سطح بررسی را با پیامد تصمیم متناسب کند. تعامل انسان و AI در چارچوب NIST
اصلاح نگارش یک عنوان با پذیرش مشخصه مؤثر بر نصب یا ادغام دو آیتم، ریسک یکسانی ندارد. بازبین مسئول باید اختیار رد پیشنهاد و ارجاع ابهام به متخصص مربوط را داشته باشد. حضور انسان زمانی مفید است که زمان، شاهد و اختیار تصمیم هم فراهم باشند.
وضعیت بررسی با وضعیت ثبت فرق دارد
«ذخیرهشده» میتواند فقط به معنی نگهداری نتیجه باشد. وضعیتهایی مانند بررسینشده، نیازمند مدرک، پذیرفتهشده یا ردشده باید معنای مستقل داشته باشند. نرمافزار باید روشن کند کدام داده در تصمیم بعدی قابل استفاده است و کدام هنوز پیشنهاد محسوب میشود.
این تفکیک اجازه میدهد کار ناتمام باقی بماند، بدون آنکه گم شود. برای موارد حساس، تغییر اطلاعات پذیرفتهشده باید دوباره به مسیر بررسی مناسب وارد شود؛ صرف اجرای مجدد AI نباید تأیید قبلی را به خروجی تازه منتقل کند. مقاله مرز پیشنهاد AI و تأیید فنی تصمیم هویتی را از همین زاویه توضیح میدهد.
پایان واقعی ورود اطلاعات
گزارش پذیرش باید مشخص کند چه دادهای از منبع آمده، چه چیزی اصلاح شده، کدام ابهام باز مانده و مسئول هر تصمیم چه کسی بوده است. شمارش ردیفهای ثبتشده برای کنترل اجرا مفید است، اما شاخص کافی برای صحت تخصصی تمام فهرست نیست.
در طراحی ورود و تکمیل اطلاعات با AI در ایدنتو، نیاز اصلی این است که نتیجه استخراج به تصمیم قابل بررسی تبدیل شود. نرمافزار باید ثبت موفق را نشان دهد و همزمان وضعیت تأیید اطلاعات را مستقل نگه دارد؛ سازمان با این تفکیک میتواند سرعت پردازش و اعتماد به داده را کنار هم دنبال کند.